Коротко
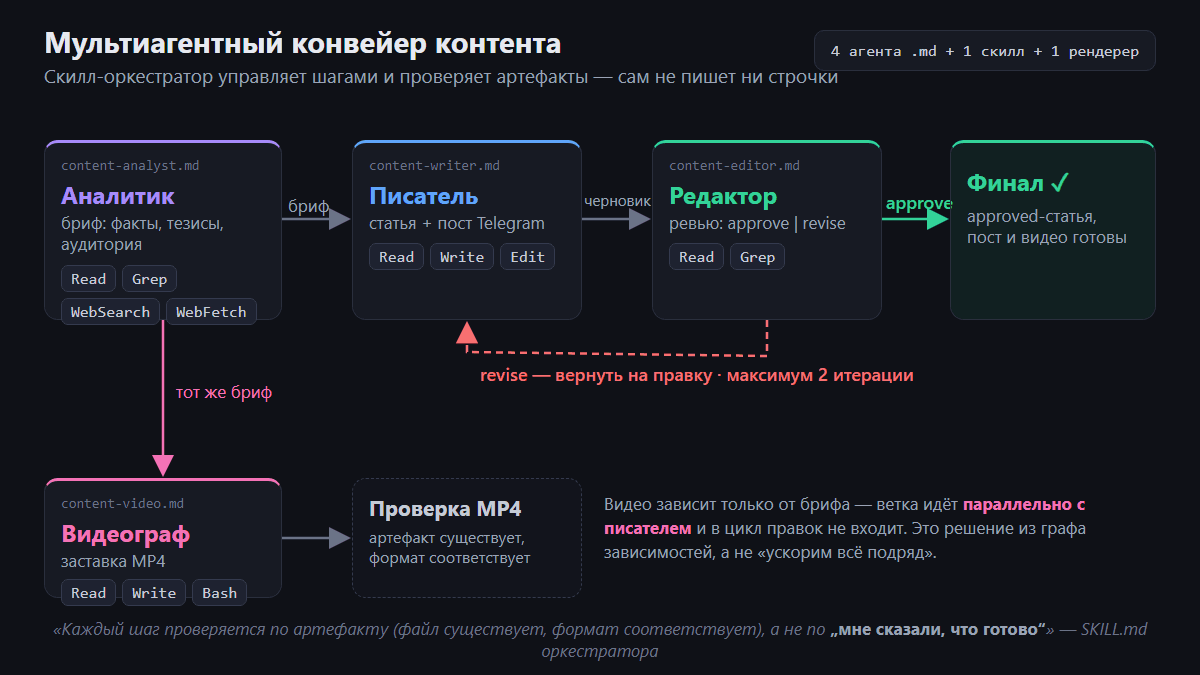
Кейс от 15.09.2026: ментор платформы собрал в Claude Code мультиагентный конвейер публикации — четыре субагента (аналитик с брифом, писатель, видеограф, редактор) плюс скилл-оркестратор, который управляет пайплайном и проверяет артефакты по факту, а не по словам агента. Вся система — из текстовых md-файлов со списками ролей и инструментов, без единой строчки своего кода. У каждого агента своя роль, свои права и отдельный контекст; редактору даны только чтение и поиск — он не переписывает текст сам, а возвращает вердикт approve или revise со списком правок. В первом полном прогоне конвейер редактор поймал в черновике две критические ошибки (ссылка на закон без даты и номера, выдуманный срок) и после двух итераций правок дал финальный вердикт approve. Кейс полезен тем, кто гоняет публикации через ИИ-агентов и не доверяет «проверь сам себя».
Что получилось: цикл качества работает как цикл — возврат на доработку встроен в схему с пределом в две итерации, дальше эскалация к человеку; видео-заставка делается параллельно со статьёй, потому что зависит только от брифа аналитика.
Ключевые находки: ограничение инструментов — это инструмент качества, а не безопасности: права заставляют агента играть роль (аналитик без записи не пишет статьи вместо брифа, редактор не «тихо правит» текст); проверять нужно артефакты — файл существует и соответствует формату, а не «агент сказал, что готово».
Грабля регистрации: субагенты регистрируются при старте сессии — созданный прямо в живой сессии агент по имени не виден («not found»); обход — запустить универсального агента и вклеить роль в промпт. Субагенты и скиллы — функция конкретного инструмента, Claude Code: в других средах ограничения будут другими.
Недавно я публиковал статью через ИИ-агента и в последний момент поймал себя на мысли: а кто проверит факты? Агент пишет уверенно, гладко, с датами и цифрами. Но если он ошибся — он же сам себя не проверит. Тот же контекст, та же память, те же слепые зоны. Просишь «проверь свой текст» — получаешь «всё отлично».
В прошлой статье, «ИИ-контент-завод», контент делал один агент плюс скилл. Теперь это конвейер из четырёх субагентов с разными ролями и — что важнее — разными правами. В первом же живом прогоне конвейер доказал, что цикл качества работает.
Сразу сниму главную иллюзию: «мультиагентность» — это не несколько разных ИИ, которые спорят друг с другом. Это одна и та же модель, но каждый экземпляр получает узкую роль, свой набор инструментов и отдельную «голову» — свой контекст без памяти о том, что писал сосед. Магии нет. Есть обычный конвейер с контрактами. И его реально собрать за вечер из текстовых файлов — без единой строчки своего кода.
Четыре роли, четыре текстовых файла
Каждый субагент в Claude Code — это отдельный md-файл с описанием роли и белым списком инструментов. Вот мои четыре (файлы лежат в ~/.claude/agents):
# content-analyst.md
name: content-analyst
description: Аналитик контент-конвейера (пайплайн content-pipeline). Разбирает тему/новость
  в структурированный бриф для автора: суть, факты, тезисы, аудитория, источники.
  Сам ничего не пишет и не публикует.
tools:
  - Read
  - Grep
  - WebSearch
  - WebFetch
# content-writer.md
name: content-writer
description: Автор контент-конвейера (пайплайн content-pipeline) — пишет статьи под
персонажем «Георгий Кодов» для платформы «Верный путь». На входе бриф аналитика,
на выходе статья + пост в Telegram. Другие площадки — зарезервированы.
tools:
- Read
- Write
- Edit# content-editor.md
name: content-editor
description: Редактор контент-конвейера (пайплайн content-pipeline). Проверяет черновик
автора против брифа аналитика: факты, стиль, длина, самоповторы. Возвращает вердикт
approve или revise со списком правок. Сам ничего не переписывает.
tools:
- Read
- Grep# content-video.md
name: content-video
description: Видеогенератор контент-конвейера (пайплайн content-pipeline). По брифу
аналитика делает короткую видео-заставку (motion-графика, MP4 1280x720 без звука)
для Telegram. Пишет HTML-композицию сам и рендерит её штатным рендерером пайплайна.
tools:
- Read
- Write
- BashСхема целиком — из описания моего скилла-оркестратора (SKILL.md):
content-analyst   -> бриф: факты, тезисы, аудитория   (tools: Read, Grep, WebSearch, WebFetch)
content-writer    -> статья + пост Telegram            (tools: Read, Write, Edit)
content-video     -> видео-заставка MP4 (motion-графика) (tools: Read, Write, Bash)
content-editor    -> ревью: approve | revise           (tools: Read, Grep)
А в виде графа зависимостей:
аналитик ──┬─> писатель ──> редактор ──┬──> approve ──> финал
           │              ▲            └──> revise ──> писатель (iteration+1) ──> редактор …
           │              <──── максимум 2 итерации правок ────>
           └─> видео (параллельно с писателем, по тому же брифу) ──> проверка MP4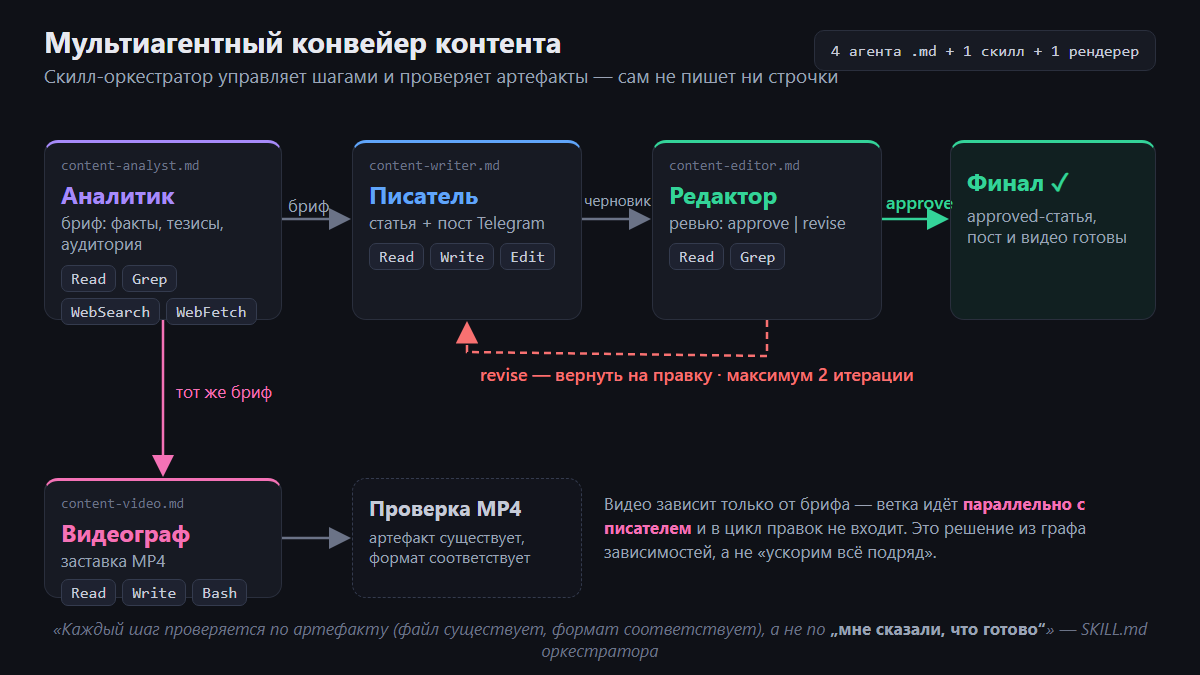
Контракт — это заранее договорённый формат входа и выхода: что агент получает на входе (путь к брифу) и что обязан вернуть (файл статьи плюс JSON-статус с полями status и verdict). Как техзадание на стыке двух отделов: пока формат не зафиксирован, каждый понимает по-своему.
Режь инструменты — это инструмент качества
Самое неожиданное для меня открытие: ограничение прав доступа — это не про безопасность, а про качество.
Посмотрите на редактора. Ему даны только Read и Grep: он физически не может «тихо поправить» неудачную фразу. У него один путь — найти проблему и объяснить, как исправить. Именно это мне и нужно: не переписанный текст, а список правок.
То же с аналитиком: без Write он не начнёт «случайно» писать статью вместо брифа. А видеограф работает только по брифу — текст статьи ему не нужен, хотя инструменты у него широкие (Read, Write, Bash).
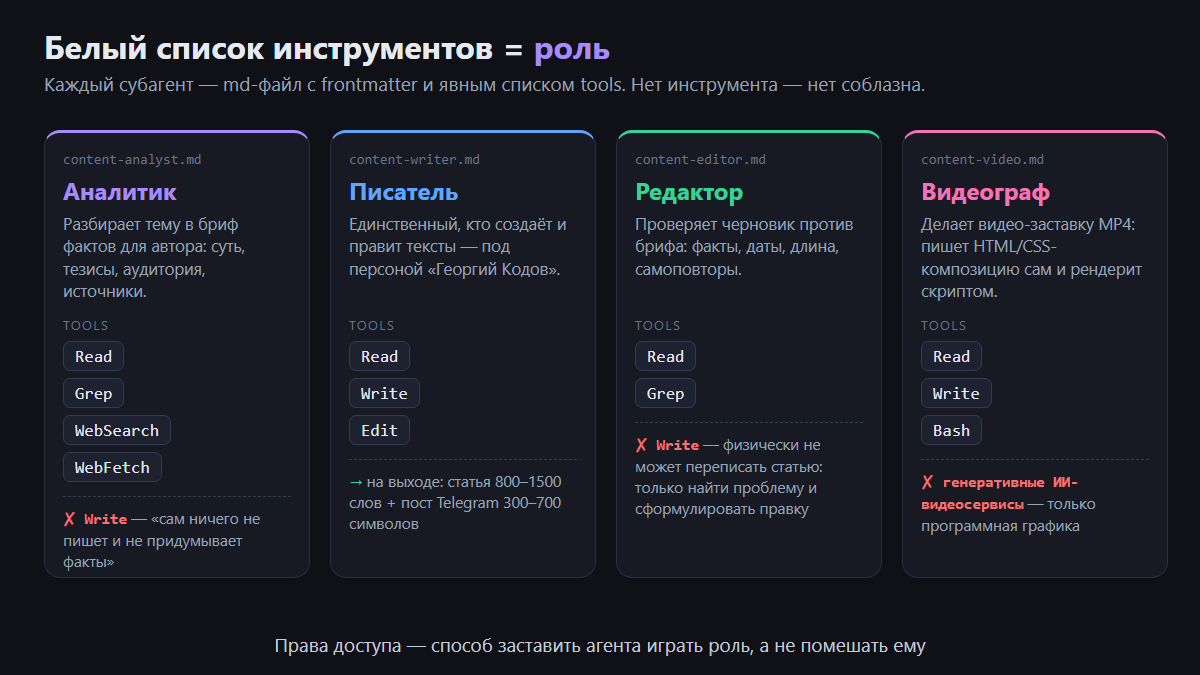
Права доступа — это способ заставить агента играть роль, а не помешать ему.
Свежий контекст ловит то, что пропускает автор
Второй принцип: у каждого субагента свой контекст. Писатель и редактор — разные сессии с разной памятью. Редактор читает статью, которую сам не писал, — глазами читателя, а не соавтора.
Именно это главное отличие от «попроси агента проверить самого себя»: автор склонен прощать свои формулировки — и человек, и ИИ.
Как это работает на практике, показал первый полный прогон конвейера. Я выпускал статью про недоступность сайта из РФ и перенос на сервер в России. Редактор поймал две критические ошибки в черновике:
закон 152-ФЗ был упомянут без точной даты и номера — а по контракту любая цифра и дата должны быть подтверждены брифом;
в тексте проскочил срок «из этих двух недель», которого в брифе вообще не было. Выдуманный факт — критическая ошибка.
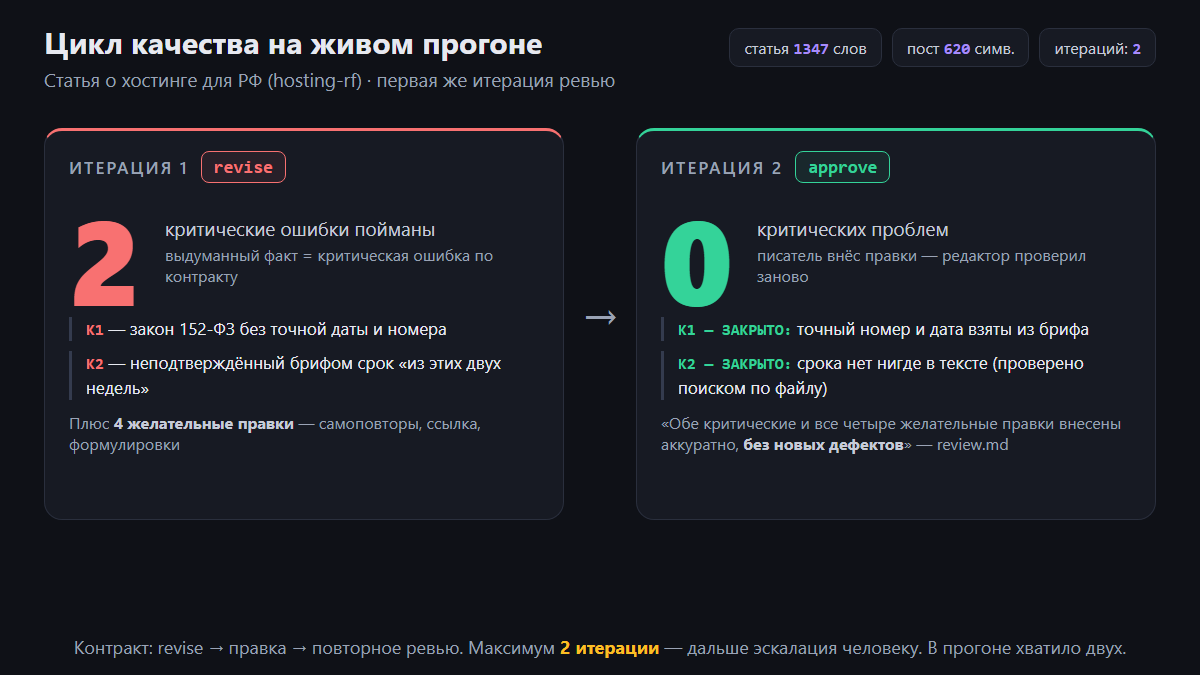
Плюс четыре желательные правки: самоповтор, неполная ссылка на источник, мета-дисклеймер и одна неудачная формулировка. Вторая итерация writer закрыл всё, финальный вердикт — approve, критических проблем ноль. В review.md при этом есть раздел «Что хорошо» — ревью не сводится к «ругани», это часть контракта.
Честная оговорка: это один прогон, а не статистика. Я не могу сказать «система ловит все ошибки». Могу сказать: в первом же прогоне она поймала две критические ошибки, которые иначе ушли бы в публикацию. Гарантий нуля ошибок нет — после двух итераций правок цикл останавливается и эскалирует к человеку.
Оркестратор — менеджер, а не автор
Четвёртый участник — скилл-оркестратор. Он ничего не пишет. Дословно из его описания: «Ты сам не пишешь брифы, статьи и посты и не правишь их содержимое. Ты только управляешь пайплайном, проверяешь артефакты и собираешь финальный отчёт».
Зато он проверяет после каждого шага — и не на словах. Ещё одна дословная строка: «Каждый шаг проверяется по артефакту (файл существует, формат соответствует), а не по „мне сказали, что готово“».
Статья существует? Объём в норме (800–1500 слов)? Пост в норме (300–700 символов)? JSON-статус — ok? Если субагент вернул error — стоп пайплайна и отчёт мне, без «додумывания» за агента.
Принцип «верь артефактам, а не словам» — самая переносимая идея отсюда: любой отчёт ИИ-агента о сделанной работе стоит проверять по факту — открыть файл, запустить тест, посмотреть на страницу.
Параллельность — из графа зависимостей, а не «для скорости вообще»
Видео-заставка для Telegram-поста делается параллельно со статьёй. Не потому что «параллельно — быстрее», а потому что видео зависит только от брифа аналитика. Статья же зависит от ревью редактора — её цепочка строго последовательная: writer → editor → (revise → writer → editor) → approve.
Это обычное инженерное мышление: нарисуй, от чего зависит каждый шаг, — и сразу видно, что гонять одновременно, а что по очереди. Программистом быть не нужно.
Отдельно про видео: никаких генеративных видеосервисов. Видеограф пишет HTML/CSS-композицию сам, а рендерит штатным скриптом. Контракт между ними зафиксирован прямо в шапке рендерера:
// Контракт с HTML-композицией:
//   - страница рассчитана на вьюпорт 1280x720 (body без прокрутки);
//   - анимация запускается сама после загрузки;
//   - В КОНЦЕ анимации страница обязана выставить document.body.dataset.done = "1";
//   - никаких внешних CDN: все стили/шрифты/графика — инлайн (системные шрифты).
Технически: Playwright записывает анимацию в webm, потом ffmpeg конвертирует в MP4 без звука (-c:v libx264 -pix_fmt yuv420p -movflags +faststart -an). В моём прогоне получилось 19,1 секунды, 6 сцен, 1,16 МБ — это цифры из отчёта оркестратора — мои данные, а не внешняя проверка.
Цикл качества — это цикл, а не надежда
Ключевая деталь, без которой схема не работает: ревью — не финальный вердикт, а часть цикла. Контракт такой: редактор возвращает verdict «revise» с файлом правок → писатель исправляет → редактор смотрит снова. Максимум две итерации, дальше — эскалация к человеку.
У редактора есть и машиночитаемый ответ, по которому оркестратор понимает, что делать дальше:
{
  "status": "ok",
  "verdict": "revise",
  "review_path": "tmp/pipeline/<slug>/review.md",
  "critical_count": 3,
  "notes": []
}
«Надежда, что агент напишет хорошо с первого раза» — это не цикл. Цикл — это когда возврат на доработку встроен в схему и у него есть предел.
Всё это — текстовые файлы, не код
Вся система — четыре md-файла агентов, один md-файл скилла и один готовый скрипт-рендер видео. Ни строчки собственного кода. Порог входа — не «написать фреймворк», а «описать роль и чек-лист словами». Это не продукт и не библиотека — личный набор конфигов для блога.
Честная грабля
Одно ограничение я узнал на практике, и о нём стоит знать заранее. Субагенты в Claude Code регистрируются при старте сессии: если создать агента прямо в текущей живой сессии, по имени он не виден — «not found». Обходной путь простой: запустить универсального агента и вклеить роль (тот самый md-файл) в промпт. Скиллы при этом подхватываются сразу, без перезапуска.
Что это значит на практике
Начинайте не с «умного агента», а с разделения ролей: тот, кто собирает факты, не должен писать текст; тот, кто пишет, не должен сам себя проверять.
Режьте инструменты по роли. Ограничение прав — способ заставить агента работать по контракту, а не помеха.
Проверяйте артефакты, а не слова. «Файл существует и соответствует формату» — критерий готовности, а не «агент сказал, что готово».
Встройте возврат на доработку в схему и ограничьте его числом итераций. После предела — человек.
Ожидания держите реалистичными: конвейер — это не «качество x2», это фильтр с проверяемым результатом.
И учтите: субагенты и скиллы — функция конкретного инструмента, Claude Code. В других средах устройство и ограничения будут другими.
Финальный вывод простой. Мультиагентность — не магия и не маркетинг. Это конвейер с контрактами, собранный из текстовых файлов: роли, права, формат входа/выхода, проверка артефактов, цикл правок с пределом. Описать это словами может любой, кто умеет ставить задачу. А качество рождается не из «более умного ИИ», а из архитектуры, в которой ошибку просто негде спрятать.